 MCMX
Cassandra (database)
Cassandra è un database management system non relazionale distribuito con licenza open source e ottimizzato per la gestione di grandi quantità di dati.
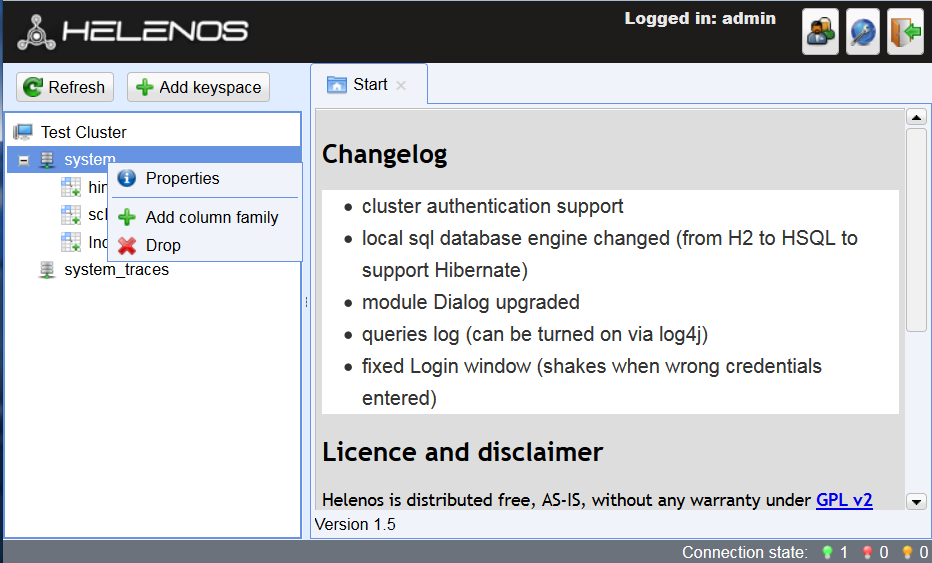
Cassandra è un database management system non relazionale distribuito con licenza open source e ottimizzato per la gestione di grandi quantità di dati.
Primi sviluppi
Il codice di Cassandra è stato inizialmente sviluppato all'interno di Facebook (per potenziare la ricerca all'interno del sistema di posta) da Avinash Lakshman e Prashant Malik.
Nel luglio del 2008 sono stati resi disponibili i sorgenti, su Google Code; dal marzo 2009 è entrato a far parte del progetto Incubator di Apache Software Foundation, data in cui l'intero progetto ha iniziato a essere distribuito sotto la Apache License 2.
Cassandra fa parte dei database detti NoSQL, una categoria molto generica che indica sommariamente i database che non sfruttano la sintassi SQL e che spesso vengono anche classificati come "non relazionali".
Cassandra è tuttora utilizzato da Facebook. Tra gli altri siti che utilizzano questo database si segnalano Twitter e Digg.
Descrizione
Apache Cassandra è un DBMS distribuito e open source. Si tratta di un progetto Top-Level (come anche CouchDB e Apache HTTP Server), sviluppato da Apache Software Foundation per gestire grandi quantità di dati dislocati in diversi server, fornendo inoltre un servizio orientato alla disponibilità, senza alcun point of failure.
È una soluzione NoSQL che inizialmente fu sviluppata da Facebook. Jeff Hammerbacher, che ha guidato il team di Facebook, ha descritto Cassandra come un modello di dati simile a BigTable in esecuzione su una infrastruttura tipi Amazon-Dynamo. Cassandra fornisce una struttura di memorizzazione chiave-valore, con eventual consistency.
Alle chiavi corrispondono dei valori, raggruppati in famiglie di colonne: una famiglia di colonne è definita quando il database viene creato. Tuttavia le colonne possono essere aggiunte a una famiglia in qualsiasi momento.
Inoltre, le colonne sono aggiunte solo specificando le chiavi, così differenti chiavi possono avere differenti numeri di colonne in una data famiglia. I valori di una famiglia di colonne sono memorizzati insieme, in quanto Cassandra adotta un approccio ibrido tra DBMS orientato alle colonne e la memorizzazione orientata alle righe.
Caratteristiche
Decentralizzato: i nodi nel cluster sono identici. Non esiste alcun single point of failure.
Fault-tolerance: i dati vengono replicati automaticamente su più nodi. È supportata la replica mediante diversi data center, e la sostituzione dei nodi può essere effettuata senza alcun downtime
Tunable consistency: il livello di coerenza (sia in scrittura che in lettura) può essere modificato (ad esempio da writes never fail a block for all replicas to be readable).
Elasticità: il throughput di lettura o scrittura scala linearmente con l'aggiunta di nuove macchine (nodi), senza downtime e senza interruzione di alcun applicativo.
Modello di dati
Una tabella in Cassandra è una mappa multi-dimensionale, distribuita, indicizzata da una chiave; il valore è un oggetto altamente strutturato. La tupla in una tabella è una stringa senza restrizioni sulla lunghezza, tipicamente lunga da 16 a 36 byte.
Ogni operazione (per ogni singola tupla) è atomica (per replica), a prescindere da quante colonne o righe saranno lette o modificate. Le colonne sono raggruppate in insiemi chiamate famiglie (column families) in maniera simile al sistema di BigTable. Le famiglie di colonne messe a disposizione da Cassandra sono due: tipo semplice e tipo super. Il tipo super column può essere rappresentato come una famiglia contenuta in un'altra famiglia. La radice è chiamata Keyspace. Cassandra gestisce mappe di 4 oppure 5 dimensioni secondo il seguente modello
Mappa di 4 dimensioni:
Keyspace → Column Family
Column Family → Column Family Row
Column Family Row → Columns
Column → Data value
Mappa di 5 dimensioni:
Keyspace → Super Column Family
Super Column Family → Super Column Family Row
Super Column Family Row → Super Columns
Super Column → Columns
Column → Data value
La prima dimensione - Keyspace → (Super) Column Family - è limitata a un (piccolo) set di chiavi predefinite nella struttura di archiviazione. La documentazione di Cassandra parla di similitudini per questa dimensione con le definizioni di tabella dei database-relazionali.
Inoltre, le applicazioni possono specificare il tipo di ordinamento delle colonne all'interno di una famiglia di colonne super o simple. Il sistema consente di riorganizzare le colonne in ordine alfabetico o in ordine cronologico.
L'ordine cronologico è sfruttato, ad esempio, dalle applicazioni di posta, dove i risultati sono sempre visualizzati dal più recente al più vecchio. Ogni colonna all'interno di una famiglia è accessibile usando la convenzione "column_family"; le colonne (e ogni altra colonna in esse contenuta) della famiglia di tipo Super sono accessibili usando la convenzione "column_family: super_column: column".
Tipicamente le applicazioni usano un cluster Cassandra dedicato la cui gestione è parte del servizio. Anche se il sistema supporta la nozione di più tabelle, tutte le distribuzioni contengono una sola tabella nel loro schema.
Grandi utenze
Facebook: usa Cassandra nella Posta in Arrivo (InBox) nel motore di ricerca, con oltre 200 nodi distribuiti.
Digg: il più grande sito di social news, ha annunciato il 9 settembre 2009 l'utilizzo di Cassandra e l'8 marzo 2010 è stato confermato e adottato.
Twitter: passa a Cassandra perché può essere eseguito/lanciato su diversi cluster server ed è capace di mantenere un'innumerevole quantità di dati.
rackspace: è conosciuto per aver usato internamente Cassandra.
Cisco Webex: usa Cassandra per memorizzare il feed dell'utente e l'attività in tempo reale.
IBM: ha sperimentato un sistema scalabile di email basato su Cassandra.
Reddit: passa a Cassandra da memcacheDB.
Cloudkick: usa Cassandra per memorizzare i parametri del server dei loro utenti.
Netflix: usa Cassandra per gestire i dati dei suoi sottoscrittori.